在高并发的应用中,限流是一个绕不开的话题。限流可以保障我们的 API 服务对所有用户的可用性,也可以防止网络攻击。
一般开发高并发系统常见的限流有:限制总并发数(比如数据库连接池、线程池)、限制瞬时并发数(如 nginx 的 limit_conn 模块,用来限制瞬时并发连接数)、限制时间窗口内的平均速率(如 Guava 的 RateLimiter、nginx 的 limit_req 模块,限制每秒的平均速率);其他还有如限制远程接口调用速率、限制 MQ 的消费速率。另外还可以根据网络连接数、网络流量、CPU 或内存负载等来限流。
本文详细探讨在 Spring Cloud Gateway 中如何实现限流。
限流算法
做限流 (Rate Limiting/Throttling) 的时候,除了简单的控制并发,如果要准确的控制 TPS,简单的做法是维护一个单位时间内的 Counter,如判断单位时间已经过去,则将 Counter 重置零。此做法被认为没有很好的处理单位时间的边界,比如在前一秒的最后一毫秒里和下一秒的第一毫秒都触发了最大的请求数,也就是在两毫秒内发生了两倍的 TPS。
常用的更平滑的限流算法有两种:漏桶算法和令牌桶算法。很多传统的服务提供商如华为中兴都有类似的专利,参考采用令牌漏桶进行报文限流的方法。
漏桶算法
漏桶(Leaky Bucket)算法思路很简单,水(请求)先进入到漏桶里,漏桶以一定的速度出水(接口有响应速率),当水流入速度过大会直接溢出(访问频率超过接口响应速率),然后就拒绝请求,可以看出漏桶算法能强行限制数据的传输速率。
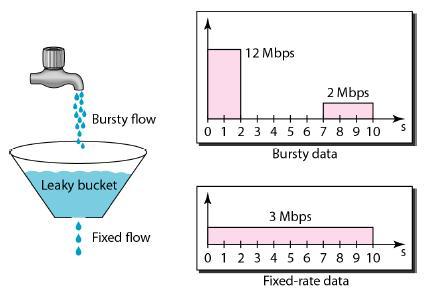
可见这里有两个变量,一个是桶的大小,支持流量突发增多时可以存多少的水(burst),另一个是水桶漏洞的大小(rate)。因为漏桶的漏出速率是固定的参数,所以,即使网络中不存在资源冲突(没有发生拥塞),漏桶算法也不能使流突发(burst)到端口速率。因此,漏桶算法对于存在突发特性的流量来说缺乏效率。
令牌桶算法
令牌桶算法(Token Bucket)和 Leaky Bucket 效果一样但方向相反的算法,更加容易理解。随着时间流逝,系统会按恒定 1/QPS 时间间隔(如果 QPS=100,则间隔是 10ms)往桶里加入 Token(想象和漏洞漏水相反,有个水龙头在不断的加水),如果桶已经满了就不再加了。新请求来临时,会各自拿走一个 Token,如果没有 Token 可拿了就阻塞或者拒绝服务。
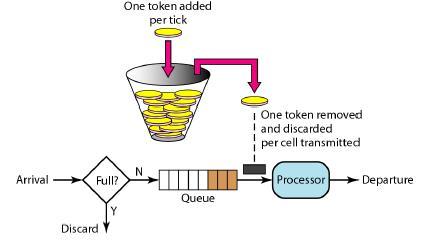
令牌桶的另外一个好处是可以方便的改变速度。一旦需要提高速率,则按需提高放入桶中的令牌的速率。一般会定时(比如 100 毫秒)往桶中增加一定数量的令牌,有些变种算法则实时的计算应该增加的令牌的数量。
Guava 中的 RateLimiter 采用了令牌桶的算法,设计思路参见 How is the RateLimiter designed, and why?,详细的算法实现参见源码。
Leakly Bucket vs Token Bucket
| 对比项 | Leakly bucket | Token bucket | Token bucket 的备注 |
|---|---|---|---|
| 依赖 token | 否 | 是 | |
| 立即执行 | 是 | 否 | 有足够的 token 才能执行 |
| 堆积 token | 否 | 是 | |
| 速率恒定 | 是 | 否 | 可以大于设定的 QPS |
限流实现
在 Gateway 上实现限流是个不错的选择,只需要编写一个过滤器就可以了。有了前边过滤器的基础,写起来很轻松。(如果你对 Spring Cloud Gateway 的过滤器还不了解,请先看这里)
我们这里采用令牌桶算法,Google Guava 的RateLimiter、Bucket4j、RateLimitJ 都是一些基于此算法的实现,只是他们支持的 back-ends(JCache、Hazelcast、Redis 等)不同罢了,你可以根据自己的技术栈选择相应的实现。
这里我们使用 Bucket4j,引入它的依赖坐标,为了方便顺便引入 Lombok
<dependency>
    <groupId>com.github.vladimir-bukhtoyarov</groupId>
    <artifactId>bucket4j-core</artifactId>
    <version>4.0.0</version>
</dependency>

<dependency>
    <groupId>org.projectlombok</groupId>
    <artifactId>lombok</artifactId>
    <version>1.16.20</version>
    <scope>provided</scope>
</dependency>
我们来实现具体的过滤器
@CommonsLog
@Builder
@Data
@AllArgsConstructor
@NoArgsConstructor
public class RateLimitByIpGatewayFilter implements GatewayFilter,Ordered {

    int capacity;
    int refillTokens;
    Duration refillDuration;

    private static final Map<String,Bucket> CACHE = new ConcurrentHashMap<>();

    private Bucket createNewBucket() {
        Refill refill = Refill.of(refillTokens,refillDuration);
        Bandwidth limit = Bandwidth.classic(capacity,refill);
        return Bucket4j.builder().addLimit(limit).build();
    }

    @Override
    public Mono<Void> filter(ServerWebExchange exchange,GatewayFilterChain chain) {
        // if (!enableRateLimit){
        //     return chain.filter(exchange);
        // }
        String ip = exchange.getRequest().getRemoteAddress().getAddress().getHostAddress();
        Bucket bucket = CACHE.computeIfAbsent(ip,k -> createNewBucket());

        log.debug("IP: " + ip + ",TokenBucket Available Tokens: " + bucket.getAvailableTokens());
        if (bucket.tryConsume(1)) {
            return chain.filter(exchange);
        } else {
            exchange.getResponse().setStatusCode(HttpStatus.TOO_MANY_REQUESTS);
            return exchange.getResponse().setComplete();
        }
    }

    @Override
    public int getOrder() {
        return -1000;
    }

}
通过对令牌桶算法的了解,我们知道需要定义三个变量:
capacity:桶的最大容量,即能装载 Token 的最大数量refillTokens:每次 Token 补充量refillDuration:补充 Token 的时间间隔
在这个实现中,我们使用了 IP 来进行限制,当达到最大流量就返回429错误。这里我们简单使用一个 Map 来存储 bucket,所以也决定了它只能单点使用,如果是分布式的话,可以采用 Hazelcast 或 Redis 等解决方案。
在 Route 中我们添加这个过滤器,这里指定了 bucket 的容量为 10 且每一秒会补充 1 个 Token。
.route(r -> r.path("/throttle/customer/**")
             .filters(f -> f.stripPrefix(2)
                            .filter(new RateLimitByIpGatewayFilter(10,1,Duration.ofSeconds(1))))
             .uri("lb://CONSUMER")
             .order(0)
             .id("throttle_customer_service")
)
启动服务并多次快速刷新改接口,就会看到 Tokens 的数量在不断减小,等一会又会增加上来
2018-05-09 15:42:08.601 DEBUG 96278 --- [ctor-http-nio-2] com.yibo.filter.RateLimitByIpGatewayFilter  : IP: 0:0:0:0:0:0:0:1,TokenBucket Available Tokens: 2
2018-05-09 15:42:08.958 DEBUG 96278 --- [ctor-http-nio-2] com.yibo.filter.RateLimitByIpGatewayFilter  : IP: 0:0:0:0:0:0:0:1,TokenBucket Available Tokens: 1
2018-05-09 15:42:09.039 DEBUG 96278 --- [ctor-http-nio-2] com.yibo.filter.RateLimitByIpGatewayFilter  : IP: 0:0:0:0:0:0:0:1,TokenBucket Available Tokens: 0
2018-05-09 15:42:10.201 DEBUG 96278 --- [ctor-http-nio-2] com.yibo.filter.RateLimitByIpGatewayFilter  : IP: 0:0:0:0:0:0:0:1,TokenBucket Available Tokens: 1
RequestRateLimiter
刚刚我们通过过滤器实现了限流的功能,你可能在想为什么不直接创建一个过滤器工厂呢,那样多方便。这是因为 Spring Cloud Gateway 已经内置了一个RequestRateLimiterGatewayFilterFactory,我们可以直接使用(这里有坑,后边详说)。
目前RequestRateLimiterGatewayFilterFactory的实现依赖于 Redis,所以我们还要引入spring-boot-starter-data-redis-reactive
<dependency>
   <groupId>org.springframework.boot</groupId>
   <artifactId>spring-boot-starter-data-redis-reactive</artifactId>
</dependency>
因为这里有坑,所以把 application.yml 的配置再全部贴一遍,新增的部分我已经用# ---标出来了
spring:
  application:
    name: cloud-gateway
  cloud:
    gateway:
      discovery:
        locator:
          enabled: true
      routes:
        - id: service_customer
          uri: lb://CONSUMER
          order: 0
          predicates:
            - Path=/customer/**
          filters:
            - StripPrefix=1
            # -------
            - name: RequestRateLimiter
              args:
                key-resolver: '#{@remoteAddrKeyResolver}'
                redis-rate-limiter.replenishRate: 1
                redis-rate-limiter.burstCapacity: 5
            # -------
            - AddResponseHeader=X-Response-Default-Foo,Default-Bar
      default-filters:
        - Elapsed=true
  # -------
  redis:
    host: localhost
    port: 6379
    database: 0
  # -------
server:
  port: 10000
eureka:
  client:
    service-url:
      defaultZone: http://localhost:7000/eureka/
logging:
  level:
    org.springframework.cloud.gateway: debug
com.yibo.filter: debug默认情况下,是基于令牌桶算法实现的限流,有个三个参数需要配置:
burstCapacity,令牌桶容量。replenishRate,令牌桶每秒填充平均速率。key-resolver,用于限流的键的解析器的 Bean 对象名字(有些绕,看代码吧)。它使用 SpEL 表达式根据#{@beanName}从 Spring 容器中获取 Bean 对象。默认情况下,使用PrincipalNameKeyResolver,以请求认证的java.security.Principal作为限流键。
关于
filters的那段配置格式,参考这里
我们实现一个使用请求 IP 作为限流键的KeyResolver
public class RemoteAddrKeyResolver implements KeyResolver {
    public static final String BEAN_NAME = "remoteAddrKeyResolver";

    @Override
    public Mono<String> resolve(ServerWebExchange exchange) {
        return Mono.just(exchange.getRequest().getRemoteAddress().getAddress().getHostAddress());
    }

}配置RemoteAddrKeyResolver Bean 对象
@Bean(name = RemoteAddrKeyResolver.BEAN_NAME)
public RemoteAddrKeyResolver remoteAddrKeyResolver() {
    return new RemoteAddrKeyResolver();
}
以上就是代码部分,我们还差一个 Redis,我就本地用 docker 来快速启动了
docker run --name redis -p 6379:6379 -d redis万事俱备,只欠测试了。以上的代码的和配置都是 OK 的,可以自行测试。下面来说一下这里边的坑。
遇到的坑
配置不生效
参考这个 issue
No Configuration found for route
这个异常信息如下:
java.lang.IllegalArgumentException: No Configuration found for route service_customer
    at org.springframework.cloud.gateway.filter.ratelimit.RedisRateLimiter.isAllowed(RedisRateLimiter.java:93) ~[spring-cloud-gateway-core-2.0.0.RC1.jar:2.0.0.RC1]
Copy
出现在将 RequestRateLimiter 配置为 defaultFilters 的情况下,比如像这样
default-filters:
  - name: RequestRateLimiter
    args:
      key-resolver: '#{@remoteAddrKeyResolver}'
      redis-rate-limiter.replenishRate: 1
      redis-rate-limiter.burstCapacity: 5
这时候就会导致这个异常。我通过分析源码,发现了一些端倪,感觉像是一个 bug,已经提交了 issue
我们从异常入手来看, RedisRateLimiter#isAllowed 这个方法要获取 routeId 对应的 routerConfig,如果获取不到就抛出刚才我们看到的那个异常。
public Mono<Response> isAllowed(String routeId,String id) {
    if (!this.initialized.get()) {
        throw new IllegalStateException("RedisRateLimiter is not initialized");
    }
    // 只为 defaultFilters 配置 RequestRateLimiter 的时候
    // config map 里边的 key 只有 "defaultFilters"
    // 但是我们实际请求的 routeId 为 "customer_service"
    Config routeConfig = getConfig().get(routeId);

    if (routeConfig == null) {
        if (defaultConfig == null) {
            throw new IllegalArgumentException("No Configuration found for route " + routeId);
        }
        routeConfig = defaultConfig;
    }

    // 省略若干代码...
}
既然这里要 get,那必然有个地方要 put。put 的相关代码在 AbstractRateLimiter#onApplicationEvent 这个方法。
@Override
public void onApplicationEvent(FilterArgsEvent event) {
    Map<String,Object> args = event.getArgs();

    // hasRelevantKey 检查 args 是否包含 configurationPropertyName
    // 只有 defaultFilters 包含
    if (args.isEmpty() || !hasRelevantKey(args)) {
        return;
    }

    String routeId = event.getRouteId();
    C routeConfig = newConfig();
    ConfigurationUtils.bind(routeConfig,args,
                            configurationPropertyName,configurationPropertyName,validator);
    getConfig().put(routeId,routeConfig);
}

private boolean hasRelevantKey(Map<String,Object> args) {
    return args.keySet().stream()
        .anyMatch(key -> key.startsWith(configurationPropertyName + "."));
}
上边的 args 里是是配置参数的键值对,比如我们之前自定义的过滤器工厂Elapsed,有个参数withParams,这里就是withParams=true。关键代码在第 7 行,hasRelevantKey方法用于检测 args 里边是否包含configurationPropertyName.,具体到本例就是是否包含redis-rate-limiter.。悲剧就发生在这里,因为我们只为 defaultFilters 配置了相关 args,注定其他的 route 到这里就直接 return 了。
现在不清楚这是 bug 还是设计者有意为之,等答复吧。
基于系统负载的动态限流
在实际工作中,我们可能还需要根据网络连接数、网络流量、CPU 或内存负载等来进行动态限流。在这里我们以 CPU 为栗子。
我们需要借助 Spring Boot Actuator 提供的 Metrics 能力进行实现基于 CPU 的限流——当 CPU 使用率高于某个阈值就开启限流,否则不开启限流。
我们在项目中引入 Actuator 的依赖坐标
<dependency>
    <groupId>org.springframework.boot</groupId>
    <artifactId>spring-boot-starter-actuator</artifactId>
</dependency>
因为 Spring Boot 2.x 之后,Actuator 被重新设计了,和 1.x 的区别还是挺大的(参考这里)。我们先在配置中设置management.endpoints.web.exposure.include=*来观察一下新的 Metrics 的能力
http://localhost:10000/actuator/metrics
{
  "names": [
    "jvm.buffer.memory.used",
    "jvm.memory.used",
    "jvm.buffer.count",
    "jvm.gc.memory.allocated",
    "logback.events",
    "process.uptime",
    "jvm.memory.committed",
    "system.load.average.1m",
    "jvm.gc.pause",
    "jvm.gc.max.data.size",
    "jvm.buffer.total.capacity",
    "jvm.memory.max",
    "system.cpu.count",
    "system.cpu.usage",
    "process.files.max",
    "jvm.threads.daemon",
    "http.server.requests",
    "jvm.threads.live",
    "process.start.time",
    "jvm.classes.loaded",
    "jvm.classes.unloaded",
    "jvm.threads.peak",
    "jvm.gc.live.data.size",
    "jvm.gc.memory.promoted",
    "process.files.open",
    "process.cpu.usage"
  ]
}
我们可以利用里边的系统 CPU 使用率system.cpu.usage
http://localhost:10000/actuator/metrics/system.cpu.usage
{
  "name": "system.cpu.usage",
  "measurements": [
    {
      "statistic": "VALUE",
      "value": 0.5189003436426117
    }
  ],
  "availableTags": []
}最近一分钟内的平均负载system.load.average.1m也是一样的
http://localhost:10000/actuator/metrics/system.load.average.1m
{
  "name": "system.load.average.1m",
  "measurements": [
    {
      "statistic": "VALUE",
      "value": 5.33203125
    }
  ],
  "availableTags": []
}
知道了 Metrics 提供的指标,我们就来看在代码里具体怎么实现吧。Actuator 2.x 里边已经没有了之前 1.x 里边提供的SystemPublicMetrics,但是经过阅读源码可以发现MetricsEndpoint这个类可以提供类似的功能。就用它来撸代码吧
@CommonsLog
@Component
public class RateLimitByCpuGatewayFilter implements GatewayFilter, Ordered {

    @Autowired
    private MetricsEndpoint metricsEndpoint;

    private static final String METRIC_NAME = "system.cpu.usage";
    private static final double MAX_USAGE = 0.50D;

    @Override
    public Mono<Void> filter(ServerWebExchange exchange, GatewayFilterChain chain) {
        // if (!enableRateLimit){
        //     return chain.filter(exchange);
        // }
        Double systemCpuUsage = metricsEndpoint.metric(METRIC_NAME, null)
                .getMeasurements()
                .stream()
                .filter(Objects::nonNull)
                .findFirst()
                .map(MetricsEndpoint.Sample::getValue)
                .filter(Double::isFinite)
                .orElse(0.0D);

        boolean ok = systemCpuUsage < MAX_USAGE;

        log.debug("system.cpu.usage: " + systemCpuUsage + " ok: " + ok);

        if (!ok) {
            exchange.getResponse().setStatusCode(HttpStatus.TOO_MANY_REQUESTS);
            return exchange.getResponse().setComplete();
        } else {
            return chain.filter(exchange);
        }
    }

    @Override
    public int getOrder() {
        return 0;
    }

}
配置 Route
@Autowired
private RateLimitByCpuGatewayFilter rateLimitByCpuGatewayFilter;

@Bean
public RouteLocator customerRouteLocator(RouteLocatorBuilder builder) {
    // @formatter:off
    return builder.routes()
            .route(r -> r.path("/throttle/customer/**")
                         .filters(f -> f.stripPrefix(2)
                                        .filter(rateLimitByCpuGatewayFilter))
                         .uri("lb://CONSUMER")
                         .order(0)
                         .id("throttle_customer_service")
            )
            .build();
    // @formatter:on
}
至于效果嘛,自己试试吧。因为 CPU 的使用率一般波动较大,测试效果还是挺明显的,实际使用就得慎重了。
示例代码可以从 Github 获取:https://github.com/zhaoyibo/spring-cloud-study
改进与提升
实际项目中,除以上实现的限流方式,还可能会:一、在上文的基础上,增加配置项,控制每个路由的限流指标,并实现动态刷新,从而实现更加灵活的管理。二、实现不同维度的限流,例如:
- 对请求的目标 URL 进行限流(例如:某个 URL 每分钟只允许调用多少次)
- 对客户端的访问 IP 进行限流(例如:某个 IP 每分钟只允许请求多少次)
- 对某些特定用户或者用户组进行限流(例如:非 VIP 用户限制每分钟只允许调用 100 次某个 API 等)
- 多维度混合的限流。此时,就需要实现一些限流规则的编排机制(与、或、非等关系)